Neste artigo
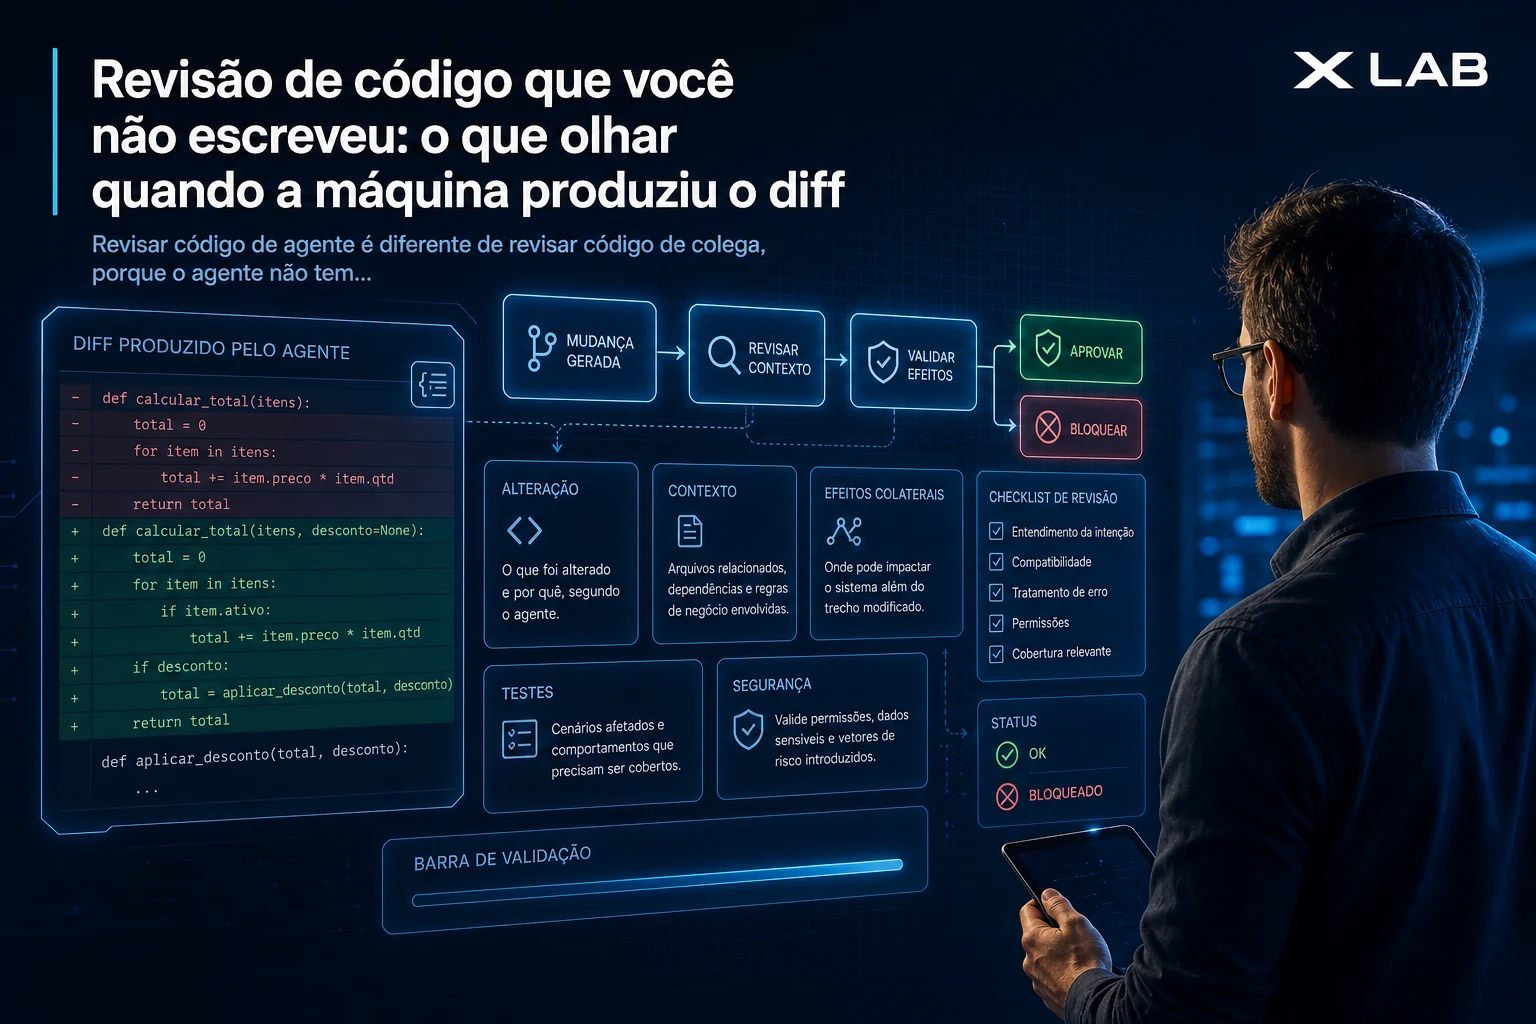
Revisar código de colega é um exercício de reconstruir intenção, e você lê o diff, imagina o que a pessoa estava tentando fazer, e avalia se o caminho faz sentido. Com código de um agente de IA, essa muleta não existe: não tem intenção pra reconstruir, tem só texto plausível.
E plausível é exatamente o problema, porque código de agente raramente é absurdo, quase sempre é razoável e às vezes errado, o que é bem mais difícil de pegar do que código obviamente ruim.
Por que revisar diff de máquina é diferente?
Por três razões práticas: a primeira é a ausência de intenção, porque quando um colega escreve algo estranho normalmente existe um motivo e perguntar resolve. Mas o agente não tinha motivo, ele tinha probabilidade.
A segunda é o volume: o diff costuma ser maior, porque gerar é barato, e revisor cansado revisa pior, com o cansaço chegando mais cedo em diff grande.
A terceira é a uniformidade enganosa: o código sai bem formatado, com nome de variável coerente e comentário no lugar. Isso baixa a guarda de quem revisa, porque a aparência de cuidado normalmente é sinal de cuidado, e aqui não é.
O que olhar primeiro para gastar menos tempo?
A ordem importa mais do que parece, e ela é do mais barato pro mais caro.
Comece pelo escopo, quais arquivos foram tocados, e se tem arquivo que não deveria estar ali, pare de revisar e volte a task, porque o agente entendeu outra coisa e o resto do diff está contaminado.
Depois olhe as fronteiras, entrada, saída, tratamento de erro, porque é onde o código gerado mais deixa buraco: o caminho feliz é o que ele modela bem.
Só então leia a lógica interna, e leia procurando decisão, não estilo, porque estilo o lint pega.
Que tipo de erro o agente comete que a pessoa não comete?
Alguns padrões se repetem o suficiente pra virar checklist.
Reimplementar o que já existe: ele não sabe que existe uma função pronta duas pastas ao lado, então escreve outra.
Tratar erro de forma decorativa: um try em volta de tudo, engolindo a causa, com log genérico, que parece robusto e é o contrário.
Inventar campo que não existe: especialmente em schema e em resposta de API, onde o nome plausível e o nome real divergem.
Otimizar o que ninguém pediu: cache, abstração, camada extra, sempre bem escrito e quase sempre desnecessário.
Teste que testa o mock: passa sempre, não prova nada, e dá sensação de cobertura.
Como usar um segundo agente na revisão sem virar teatro?
Funciona, com duas condições: a primeira é que quem revisa não pode ser quem escreveu, nem a mesma sessão. Porque modelo revisando o próprio trabalho concorda consigo mesmo com uma facilidade que não ajuda ninguém.
A segunda é dar critério, não pedir opinião: “Está bom?” produz elogio. “Liste onde a entrada não é validada, onde o erro é engolido e onde há reimplementação de algo que já existe no repositório” produz achado.
E trate o resultado como pista, não como veredito, porque revisor automático também erra, inclusive apontando problema que não existe.
O que automatizar para não depender de disciplina?
Tudo que tem resposta objetiva deveria falhar sozinho, antes de chegar em gente.
Typecheck, lint, teste, cobertura do caminho que a task prometia, e uma verificação de que os arquivos tocados são os previstos. Nenhuma dessas exige julgamento, e todas são coisas que revisor humano cansado deixa passar.
O que sobra pra pessoa é o que exige contexto de negócio e decisão de arquitetura, que é, convenientemente, a parte que o agente faz pior.
Quando é mais barato jogar fora e refazer?
Quando você já está na terceira rodada de correção do mesmo diff.
A partir dali, o custo de entender o que já foi feito passa a ser maior que o de recomeçar com uma task melhor escrita. E na maior parte das vezes o problema era a task, não o agente, então recomeçar com o mesmo pedido só reproduz o resultado.
| Sinal | Quando aparece |
|---|---|
| Hora de jogar fora e recomeçar | 3ª rodada de correção do mesmo diff |
| Condições pra revisão cruzada valer | 2 (revisor diferente de quem escreveu, e critério explícito no pedido) |
| Segundo o texto acima, apurado em agosto de 2026 | |
O sinal de alerta é você se pegar explicando ao agente por que a correção anterior não resolveu, e nesse ponto, apague e reescreva a especificação.