Neste artigo
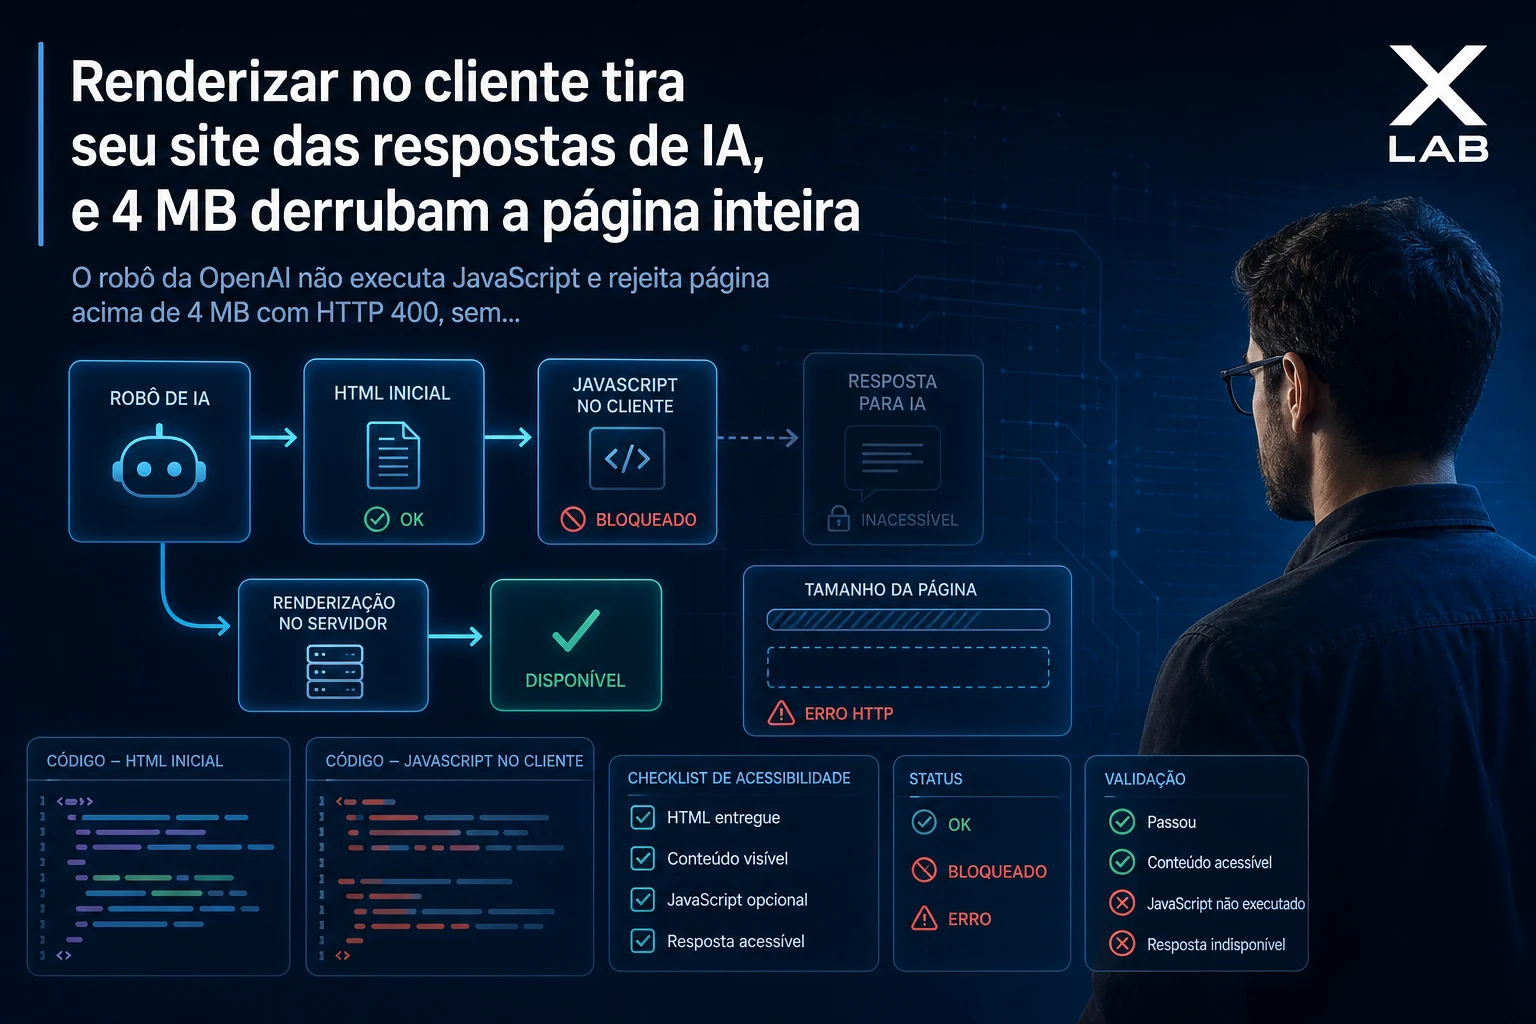
Se o conteúdo do seu site só existe depois que o JavaScript roda, o robô da OpenAI não vê nada. Ele não executa JavaScript. E se a página passar de 4 MB, ela é rejeitada com HTTP 400, não lida parcialmente: página pesada demais simplesmente não existe para o modelo.
São dois limites duros, de infraestrutura, que nenhuma quantidade de conteúdo bom compensa.
Por que renderizar no cliente é um problema aqui?
Porque o Googlebot te acostumou mal. Ele executa JavaScript há anos, em uma segunda passada, então SPA em React ou Vue acaba ranqueando mesmo sem renderização no servidor.
Os robôs de IA são mais simples. Eles baixam o HTML e convertem para texto. O que estiver no HTML inicial existe. O que depender de fetch depois do carregamento, não.
O teste é de trinta segundos e não precisa de ferramenta:
curl -s https://seusite.com.br/pagina-importante/ | wc -c
curl -s https://seusite.com.br/pagina-importante/ | grep -c "uma frase que aparece na tela"
Se a contagem der zero, o robô não lê aquele texto. Se o tamanho passar de 4.000.000, você está no limite de rejeição.
Como o robô transforma a página em texto?
Convertendo HTML para Markdown, e essa conversão tem personalidade própria:
| Elemento | Sobrevive? |
|---|---|
| Texto do HTML inicial | sim |
alt de imagem |
sim |
| Texto escondido por CSS | sim, o robô lê o que o humano não vê |
<script>, <iframe> |
não |
| JSON-LD (dados estruturados) | não |
| Conteúdo carregado por JavaScript | não |
O JSON-LD ser descartado surpreende quem investiu em schema. Não torna o investimento inútil: ele continua desambiguando entidade para Google e Bing, e os pipelines alimentados por Google respondem por cerca de 75% do modo pago do ChatGPT. Só não é a alavanca de citação que muita agência vende.
O que costuma estourar 4 MB?
Raramente é texto. Quase sempre é uma destas quatro:
- Imagem em base64 dentro do HTML, prática comum em e-mail e em builder visual
- Estado inicial gigante em
<script>, do tipo que framework moderno gera para hidratar a página - Catálogo inteiro embutido numa página de listagem sem paginação
- CSS crítico duplicado em toda página, quando alguém automatizou errado
Nenhuma dessas aparece como problema em teste de velocidade, porque o navegador aguenta bem. O robô não.
Preciso migrar de framework?
Quase nunca. O que resolve é garantir HTML no servidor para as páginas que precisam ser encontradas, e isso não exige reescrever o sistema.
Na ordem do menor esforço:
- Renderização estática para conteúdo que muda pouco: blog, páginas institucionais, documentação. É o caminho mais barato e o mais rápido.
- Renderização no servidor para o que muda por requisição.
- Manter no cliente tudo que é área logada, painel e ferramenta interna, que não precisa ser lido por robô nenhum.
Repare que isso é a mesma separação que já se faz por outros motivos: performance, cache e custo. Vale a pena decidir isso cedo, junto com as outras decisões de arquitetura, porque depois vira projeto.
Onde performance entra nessa conta?
Entra como filtro, não como desempate. 85% das páginas citadas por IA passam nos três Core Web Vitals, contra 39% da média da web, e página com LCP acima de 4 segundos tem 72% menos chance de ser citada.
A causa mais comum de LCP ruim em site de conteúdo continua sendo a mesma de sempre: imagem de capa pesada. Num blog nosso, uma capa em JPG de 854 KB puxava o LCP para 6,6 segundos. A conversão da biblioteca inteira para WebP levou a pasta de 49,5 MB para 18,2 MB, uma queda de 63%, sem nenhuma mudança de layout.
O checklist de infraestrutura
- O texto principal aparece em
curl, sem JavaScript - A página pesa menos de 4 MB, contando o HTML inteiro
robots.txtconferido no ar, semDisallowinesperado de CDN- Status 200 para
OAI-SearchBot,GPTBotePerplexityBot - LCP abaixo de 2,5 segundos no mobile
- Imagens em formato moderno, com dimensão declarada
Seis itens, todos verificáveis por linha de comando, nenhum dependendo de opinião.
Perguntas frequentes
Meu site é WordPress. Estou seguro?
Na maior parte dos casos, sim, porque WordPress entrega HTML pronto. Os riscos ali são outros: plugin que injeta Disallow, página construída com builder que embute imagem em base64, e tema que carrega conteúdo por AJAX.
E aplicação de página única que é o produto em si?
Painel logado não precisa ser lido por robô. O que precisa é a camada pública: home, páginas de produto, preço, documentação e blog. Essas podem ser estáticas mesmo com o produto sendo SPA.
Como sei se já estou sendo lido?
Log de robô verificado por IP, nunca por user-agent, que é texto livre e qualquer um forja. E, para o ChatGPT especificamente, existe teste direto que responde se a URL está no índice. Peça um diagnóstico se quiser essa leitura feita no seu caso.