Neste artigo
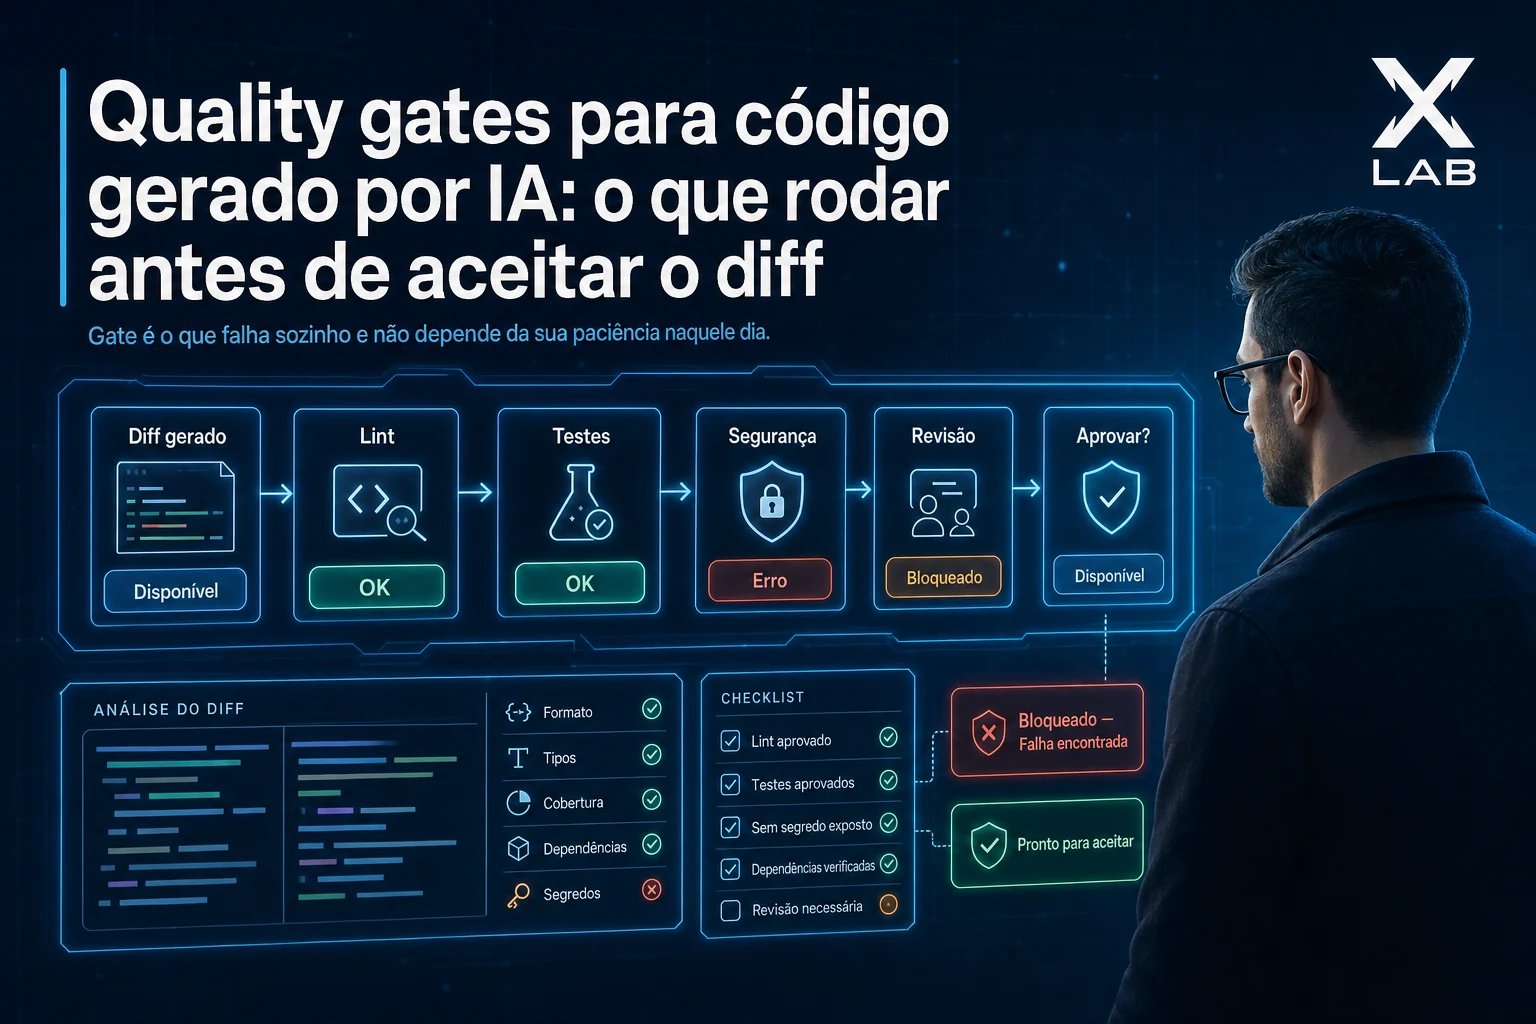
Gate é uma verificação que roda sozinha e devolve sim ou não, sem depender de alguém estar disposto a olhar com atenção. Em código escrito à mão isso já é boa prática. Em código gerado por um agente de IA, é o que separa um fluxo que escala de um que acumula problema em silêncio.
A razão é o volume, porque quando produzir ficou barato, revisar virou o gargalo, e revisor humano cansa, mas gate não cansa.
Por que revisão humana sozinha não escala aqui?
Porque a quantidade de diff cresceu e a sua capacidade de julgar não, e tem ainda um efeito perverso. Código gerado parece cuidado, com formatação boa, nomes coerentes e comentário no lugar, e isso baixa a guarda de quem revisa, porque aparência de cuidado normalmente é sinal de cuidado, e aqui não é.
Quais verificações rodar, e em que ordem?
Do mais barato pro mais caro, porque o barato elimina a maioria antes de você pagar pelo caro.
1) Escopo de arquivos: o diff tocou só o que a task previa? É a checagem mais barata e a que mais economiza, porque arquivo inesperado quase sempre significa que o agente entendeu outra coisa, e aí o resto não vale revisar.
2) Typecheck e lint: rápido, e pega mais do que se imagina em código gerado.
3) Testes existentes: regressão é o risco mais concreto de mudança feita por quem não conhece o sistema inteiro.
4) O teste que a task prometeu: se o critério de aceite falava em 401 sem corpo, tem que existir teste do 401 sem corpo, e sem isso, o critério era decorativo.
5) Verificação de segredo e de dependência nova: chave em código e biblioteca que ninguém aprovou são dois problemas que o agente introduz com naturalidade.
6) Revisão cruzada automatizada: um segundo modelo lendo o diff com critério explícito, e é o mais caro dos seis e o que pega o que os outros não pegam.
| Dado | Medida |
|---|---|
| Verificações no pipeline completo | 6 gates, do mais barato ao mais caro |
| Cobertura de teste que vira teatro | 90% de exigência |
| Segundo o texto acima, apurado em agosto de 2026 | |
Como escrever gate que não vira ruído?
Gate com falso positivo é pior que gate nenhum, porque as pessoas aprendem a ignorar, e aí quando ele acerta ninguém acredita.
Duas regras que eu sigo: a primeira é que todo gate precisa ter sido testado com um caso que ele deve reprovar, não só com um que deve aprovar. Porque gate testado só no caso bom pode estar aprovando tudo e você não saberia.
A segunda é que a mensagem de falha tem que dizer o que fazer: “Falhou na validação” manda a pessoa investigar, enquanto “O arquivo X foi tocado e não estava na task” resolve em cinco segundos.
O que não deve virar gate?
Tudo que depende de julgamento. Se a arquitetura é adequada, se a abstração vale a pena, se o nome comunica bem, nada disso tem resposta objetiva, e transformar em regra automática produz regra burra que as pessoas contornam.
Cobertura de teste como número absoluto entra na mesma categoria, porque exigir noventa por cento gera teste escrito pra subir número, e teste escrito pra subir número testa o mock.
Como o gate muda quando são dois agentes em paralelo?
O gate de escopo passa a ser o mais importante de todos, porque com um agente, tocar arquivo fora do previsto já é sinal de mal-entendido. Com dois em paralelo, é também risco de conflito: o outro pode estar mexendo naquele arquivo agora.
Por isso a lista de arquivos previstos deixa de ser documentação e vira contrato. Se a task não declara o que vai tocar, não dá pra saber se duas tasks são paralelas de verdade.
Por onde começar se hoje não existe gate nenhum?
Pelos dois primeiros da lista, escopo e typecheck, e só, porque juntos custam pouco pra montar e filtram uma fatia grande do que hoje chega em revisão humana. Os outros quatro você acrescenta conforme doer, e vão doer em ordem diferente dependendo do projeto.
Montar os seis de uma vez é o caminho conhecido pra abandonar todos na segunda semana.