Neste artigo
Quando a saída de um agente de IA começa a piorar, a explicação que aparece primeiro é sempre a mesma: o modelo piorou. Às vezes é verdade, e é a hipótese menos provável e a menos acionável.
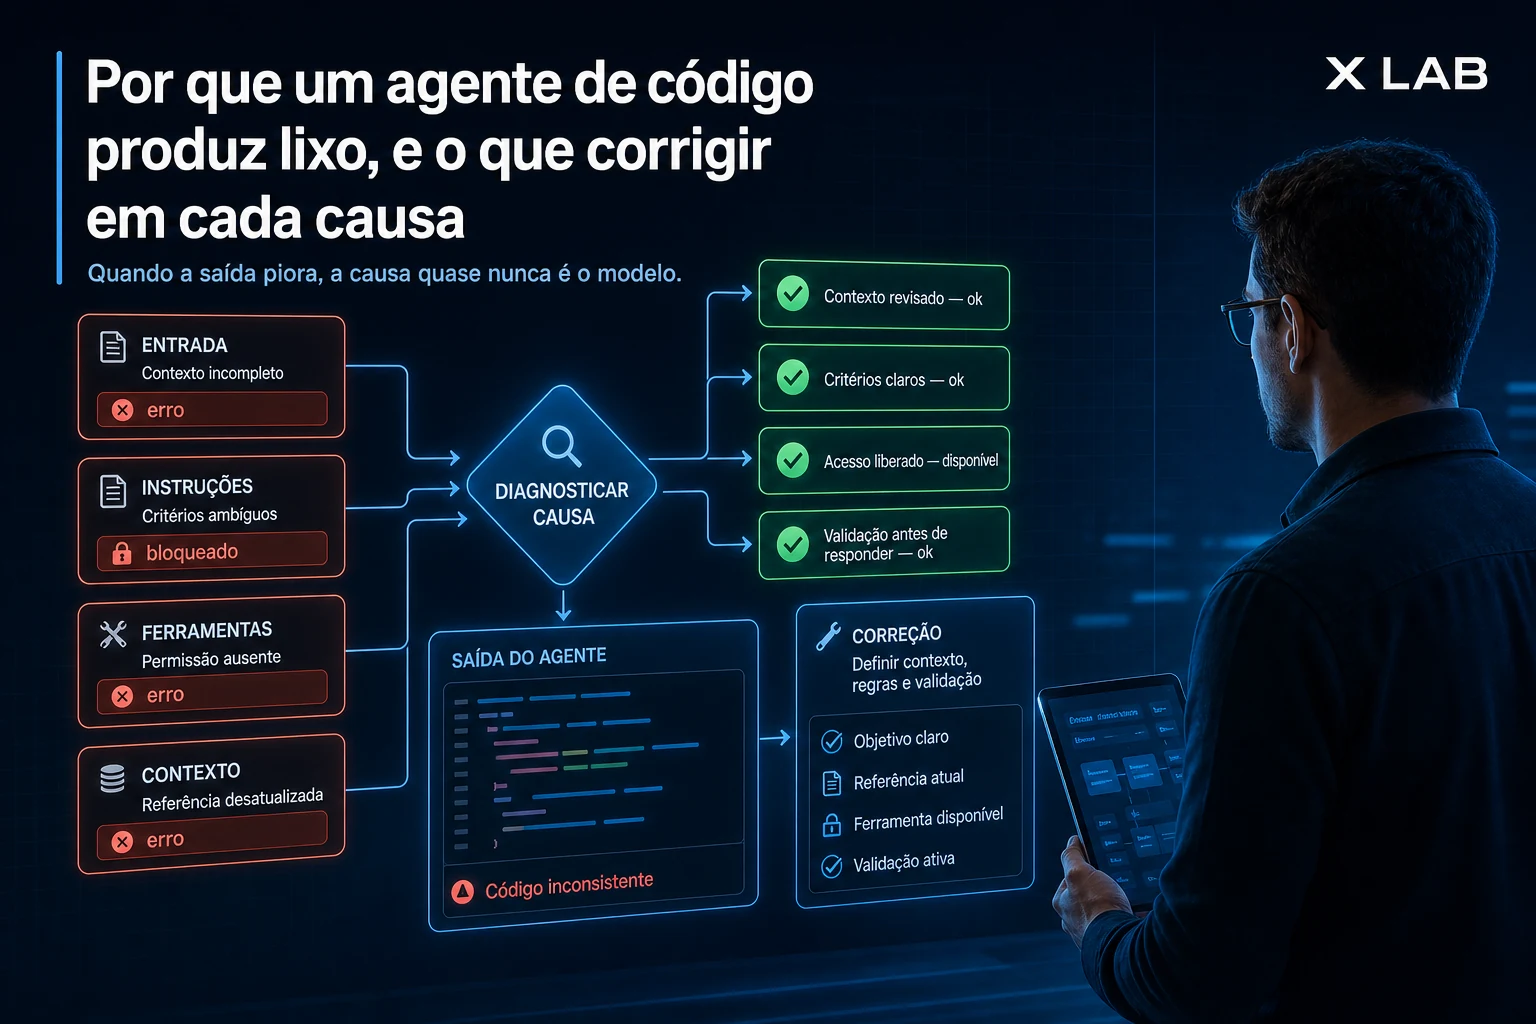
Nas vezes em que eu fui atrás, a causa era uma de cinco, todas do meu lado, e cada uma tem uma correção diferente. Tratar as cinco como se fossem uma só é o motivo de tanta gente ficar trocando de ferramenta sem melhorar o resultado.
| O que | Medida |
|---|---|
| Causas por trás da queda de qualidade | 5 causas distintas |
| Tempo até o padrão errado se espalhar | 2 semanas para chegar a 5 lugares |
| Segundo a experiência descrita no texto, apurada em agosto de 2026 | |
Causa 1: falta contexto, e como isso se manifesta?
O sintoma é código que ignora o que já existe, função duplicada, padrão diferente do resto do projeto, nome que não segue a convenção.
O agente não é adivinho: se ninguém disse que existe um utilitário de data em lib/date, ele escreve outro. A correção é dar o mapa antes da task, e o mapa mais barato é um arquivo de instruções do repositório dizendo onde as coisas moram e o que não deve ser recriado.
Causa 2: contexto demais também estraga?
Estraga, e essa é contraintuitiva o suficiente pra pegar gente experiente, porque quando você entrega trinta arquivos e dois são relevantes, a atenção do modelo se espalha. O sintoma é resposta genérica, que mistura padrão de partes diferentes do sistema, ou que responde a uma pergunta próxima da que você fez.
A correção é curadoria, a pasta da feature, o documento de arquitetura, e mais nada, e se faltar, ele pede, então você entrega o pedaço específico. Menos contexto e mais certo bate mais contexto e vago quase sempre.
Causa 3: a task estava vaga, e como saber?
O teste é tentar escrever “está pronto quando ___” sem usar “funcionar bem” ou “estar correto”, e se você não consegue, o agente também não conseguia saber.
O sintoma dessa causa é o diff que resolve outro problema, parecido com o seu, e não é desatenção do modelo, é que o pedido admitia várias leituras e ele escolheu uma.
A correção é critério de aceite explícito, com entrada, saída e caso de erro, chato de escrever, mas é o que transforma revisão de meia hora em revisão de dez segundos.
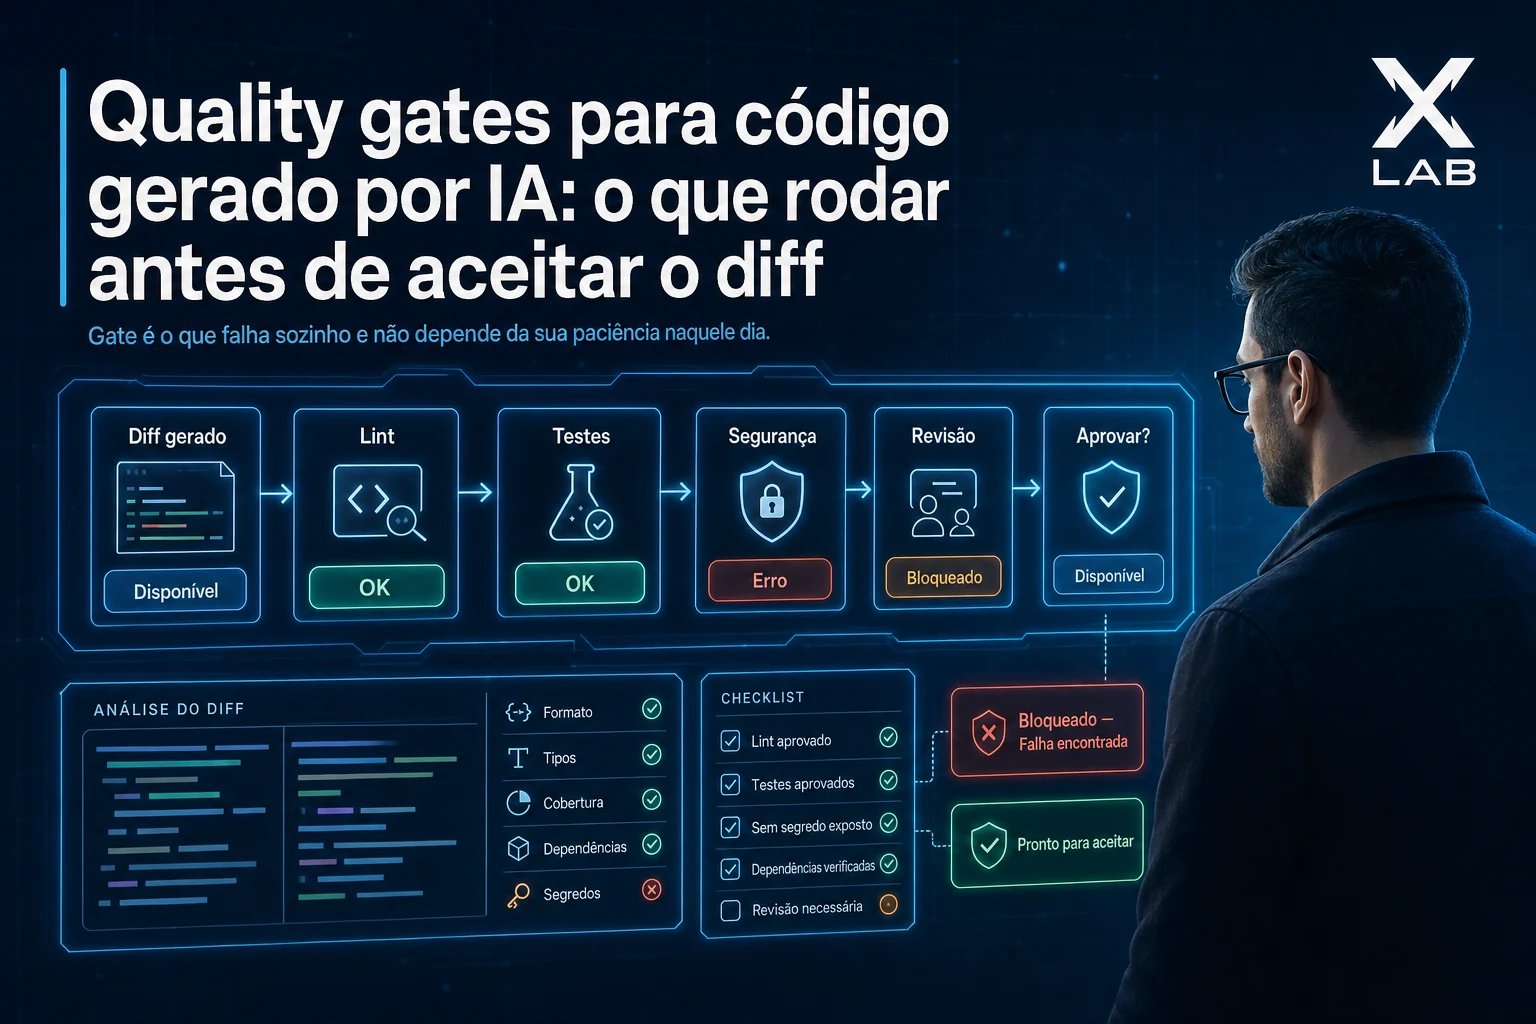
Causa 4: não existe gate, e por que isso degrada com o tempo?
Sem verificação automática, o que passa é o que o revisor teve paciência de olhar naquele dia, e paciência varia.
O efeito é cumulativo: uma inconsistência entra, o agente lê aquele código na próxima sessão, entende que aquilo é o padrão da casa, e reproduz; em duas semanas o padrão errado está em cinco lugares.
A correção é ter gate que falha sozinho, com typecheck, lint, teste, e conferência de escopo dos arquivos tocados, porque o ponto não é pegar tudo, é impedir que o erro vire referência.
Causa 5: a sessão está contaminada, e quando reiniciar?
Sessão longa acumula tentativa errada, e o agente lê o próprio histórico como se fosse informação boa.
O sintoma é ele insistir numa abordagem que já falhou duas vezes, ou voltar a um erro que já tinha sido corrigido. Não é teimosia, é que o erro está no contexto dele com o mesmo peso da correção.
A correção é reiniciar a sessão e recarregar só o estado bom, o código atual, a task e a decisão, porque perder o histórico aqui é ganho, não perda.
Como saber qual das cinco é a sua?
Um diagnóstico rápido, na ordem em que eu tentaria: se o código ignora o que existe, é falta de contexto; se a resposta é genérica, é contexto demais; se resolve outro problema, a task estava vaga. Se o erro se repete em vários arquivos ao longo de semanas, falta gate; se o agente insiste no que já falhou, a sessão está contaminada.
Só depois de descartar as cinco vale considerar trocar de modelo, porque na minha experiência, essa é a última que resolve e a primeira que as pessoas tentam.