Neste artigo
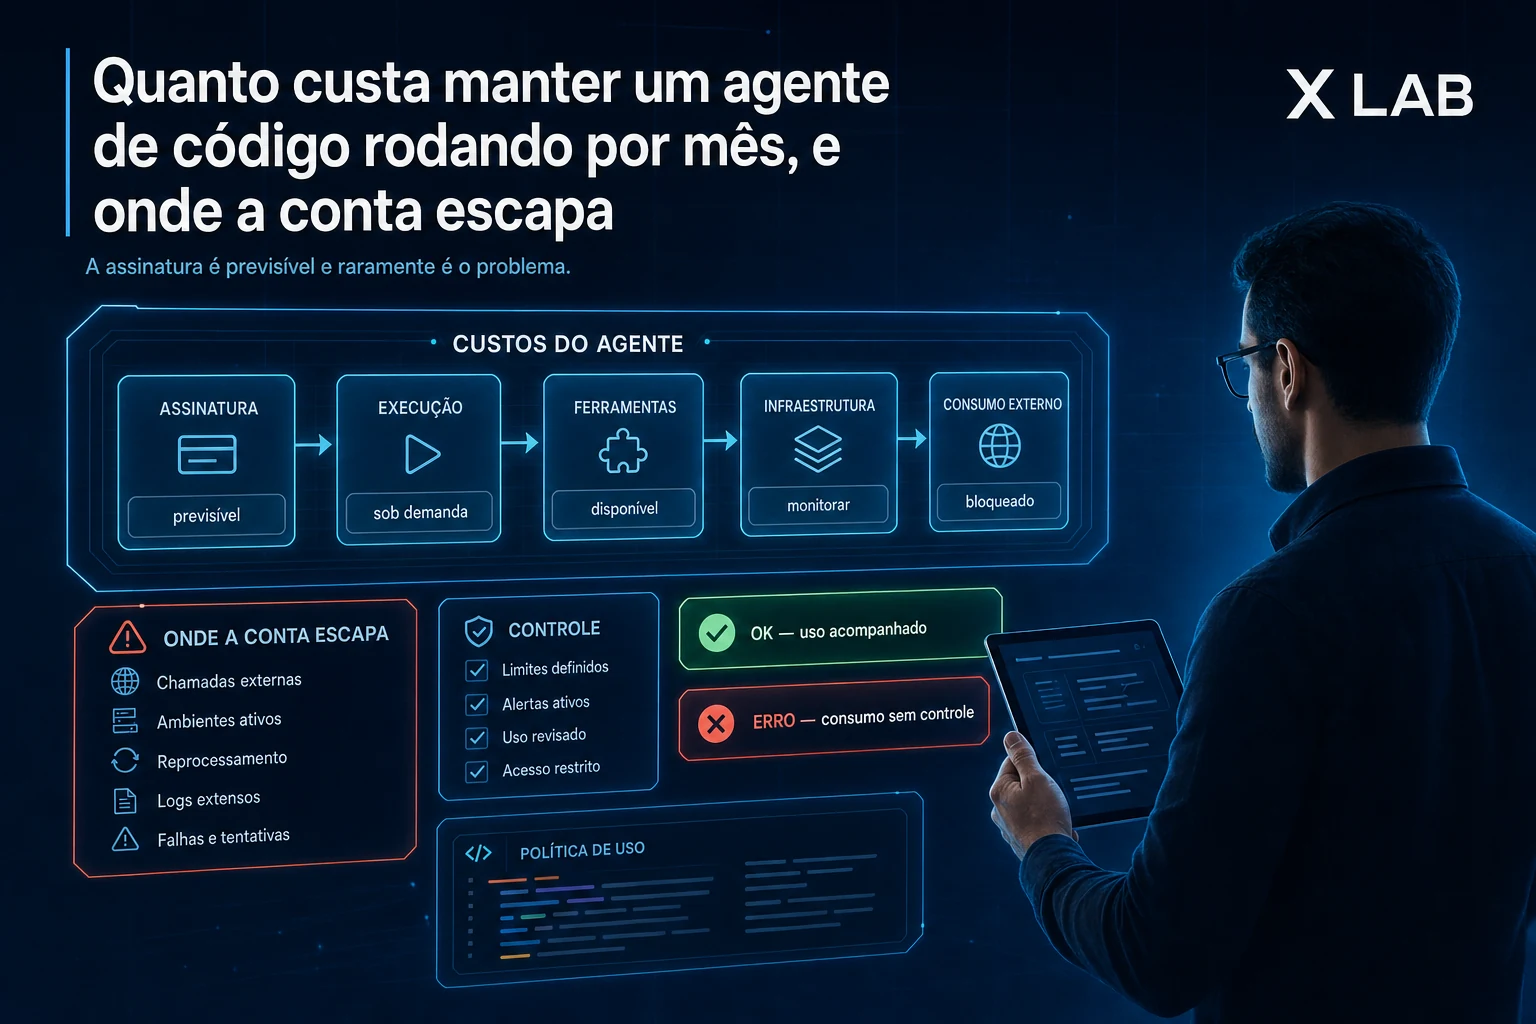
A conta do agente de IA para código parece simples: assinatura mensal, valor fixo, fim. Na prática o valor fixo é a parte pequena e previsível, e o que desarruma o orçamento está em três lugares que quase nunca entram na planilha.
Onde exatamente o dinheiro sai?
Vale separar, porque cada um tem uma dinâmica diferente.
Assinatura de plano fixo: previsível, com limite de uso por janela, e o risco aqui não é o preço, é bater no limite no meio de um trabalho.
Consumo por token, quando é via API: aqui não tem teto, e é onde acontece susto, porque escala com o tamanho do contexto, e não com a dificuldade da tarefa.
Infraestrutura induzida: quando a entrega acelera, o que estava numa máquina só passa a precisar de ambiente de teste, fila e banco separado. Isso é custo real, causado pelo agente, mas nunca atribuído a ele.
Por que o contexto pesa mais que o pedido?
Porque ele é reenviado a cada rodada.
Um pedido de duas linhas com trinta arquivos de contexto custa muito mais que um pedido de trinta linhas com dois arquivos. E como uma sessão de trabalho tem dezenas de rodadas, o contexto é multiplicado por todas elas.
| Cenário de pedido | Linhas do pedido | Arquivos de contexto |
|---|---|---|
| Pedido enxuto, contexto pesado | 2 linhas | 30 arquivos |
| Pedido extenso, contexto leve | 30 linhas | 2 arquivos |
| Segundo o exemplo deste texto, o primeiro cenário sai mais caro; atualizado em agosto de 2026 | ||
É por isso que curadoria de contexto é otimização de custo, não só de qualidade. Entregar a pasta da feature em vez do repositório inteiro reduz a conta e melhora o resultado ao mesmo tempo, o que é raro.
Quanto o cache muda essa conta?
Bastante, quando o padrão de uso permite.
Cache de prompt faz o trecho estável do contexto, tipo as instruções do projeto e a documentação de arquitetura, custar bem menos nas chamadas seguintes. Isso só compensa quando esse trecho é realmente estável.
O erro que anula o benefício é montar o contexto numa ordem diferente a cada chamada, ou enfiar algo variável no começo, porque aí nada casa e você paga cheio sempre.
Qual é o custo que ninguém contabiliza?
O retrabalho, e ele costuma ser maior que a assinatura inteira.
Toda vez que um diff é rejeitado e refeito, você pagou duas vezes pelo mesmo resultado, em consumo e em hora sua. Quando isso vira rotina, o custo por entrega útil sobe muito, mesmo com a fatura estável.
A causa quase sempre é a mesma, task vaga, e especificação melhor é a otimização de custo mais barata que existe, porque não exige mudar ferramenta nem plano.
Como estimar antes de adotar em equipe?
Roda uma semana com uma pessoa, medindo três coisas: consumo, número de rodadas por task e taxa de rejeição de diff.
Depois multiplica pela equipe e aplica uma margem generosa, porque quem adota depois usa pior no começo, e se a conta só fecha no cenário otimista, ela não fecha.
Vale também simular o mês ruim, aquele em que tem incidente e refatoração grande ao mesmo tempo, porque orçamento dimensionado pelo mês bom estoura no primeiro trimestre.
Quando vale trocar plano fixo por API, e o contrário?
Plano fixo compensa em uso interativo, feito por pessoa, com pausas, e é previsível, raramente surpreende.
API compensa quando o uso é programático e você controla o tamanho do contexto: pipeline, automação, tarefa em lote, e aí você paga pelo que usa e consegue otimizar de verdade.
A configuração que costuma dar errado é usar API pra trabalho interativo sem limite configurado, porque uma sessão longa com contexto grande consegue gastar num dia o que o plano fixo custaria no mês.