Neste artigo
- Por que a demo engana?
- 1. Que limites precisam estar escritos?
- 2. Por que a avaliação precisa rodar a cada mudança?
- 3. Como colocar teto de custo por conversa e por dia?
- 4. Como fazer o repasse para humano funcionar?
- 5. Por que registrar o que o agente respondeu?
- O que costuma dar errado nos primeiros 30 dias?
- Perguntas frequentes
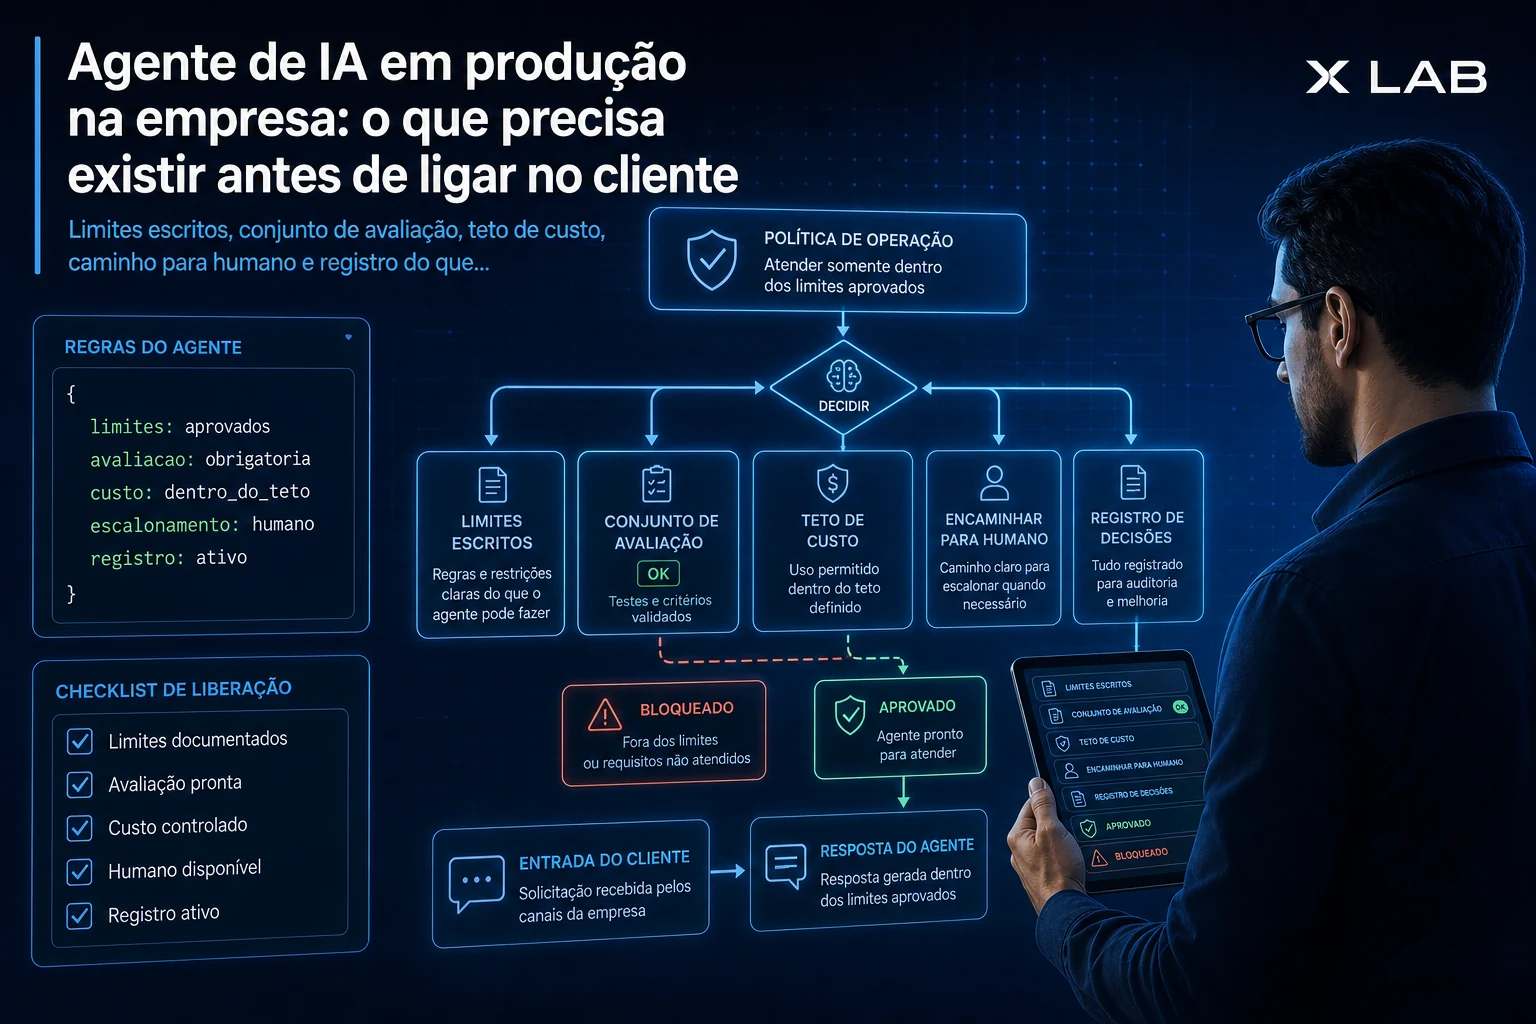
Antes de um agente de IA falar com cliente real, cinco coisas precisam existir: limites do que ele pode fazer, um conjunto de avaliação que roda a cada mudança, teto de custo por conversa, caminho de escalonamento para humano, e registro do que ele respondeu. Sem isso não é agente em produção, é demonstração com risco.
Por que a demo engana?
Agente demonstra muito bem. Você faz cinco perguntas, ele responde as cinco com competência, e a sensação é de estar pronto.
O que a demo não mostra: o que ele responde na pergunta número duzentos, feita de um jeito que ninguém previu, por alguém irritado, sobre um assunto adjacente ao que ele deveria cobrir. E não mostra quanto custou.
A diferença entre demo e produção não é o modelo, é o que existe em volta dele.
1. Que limites precisam estar escritos?
Precisa estar definido o que o agente pode afirmar, o que ele nunca afirma, e o que ele faz quando não sabe. Especialmente: ele pode prometer prazo? Pode dar desconto? Pode falar sobre concorrente? Pode opinar sobre assunto fora do escopo?
Sem isso escrito e testado, o padrão do modelo é ser prestativo, e ser prestativo inclui inventar quando não sabe. Isso vira problema quando o cliente imprime a tela.
2. Por que a avaliação precisa rodar a cada mudança?
Esse é o item que separa quem opera de quem experimenta. É um conjunto de casos, com resposta esperada, que roda a cada mudança de prompt, de modelo ou de base de conhecimento.
Sem ele, toda alteração é aposta: você melhora uma resposta e piora três outras sem saber. Com ele, você vê a regressão antes do cliente.
Precisa incluir os casos ruins: pergunta ambígua, cliente irritado, tentativa de fazer o agente sair do papel, pergunta sobre assunto que ele não cobre.
3. Como colocar teto de custo por conversa e por dia?
Custo de LLM cresce silenciosamente. Uma conversa longa com histórico inteiro reenviado a cada mensagem custa múltiplas vezes uma conversa curta, e ninguém percebe até a fatura.
O mínimo: limite de tokens por conversa, limite de conversas por usuário por dia, alerta quando o custo diário passa do esperado, e monitoramento de custo por conversa ao longo do tempo.
| Sem controle | Com controle |
|---|---|
| Descobre o custo na fatura | Alerta quando desvia do normal |
| Uma conversa pode custar o dia inteiro | Teto por conversa |
| Abuso automatizado passa | Limite por usuário |
| Não sabe qual fluxo custa mais | Custo por tipo de conversa |
4. Como fazer o repasse para humano funcionar?
Todo agente precisa saber desistir. Precisa estar definido o que dispara o repasse: cliente pedindo, assunto fora do escopo, duas tentativas sem resolver, ou detecção de irritação.
E o repasse tem que funcionar de verdade, com o histórico da conversa chegando junto. Repasse que faz o cliente repetir tudo é pior do que não ter agente.
5. Por que registrar o que o agente respondeu?
Quando o cliente disser que o sistema prometeu algo, você precisa poder verificar. Guarde a conversa, a versão do prompt e o modelo usado, com prazo de retenção definido e sem dado pessoal desnecessário.
Isso é operação, e também é proteção jurídica.
O que costuma dar errado nos primeiros 30 dias?
- Custo três vezes acima do previsto, quase sempre por histórico crescendo sem limite
- Resposta confiante e errada sobre um detalhe de produto que mudou e ninguém atualizou na base
- Agente saindo do papel quando o cliente insiste, porque o limite era sugestão e não regra
- Escalonamento que perde o contexto, e o cliente repetindo tudo para o humano
Os quatro são previsíveis, e por isso viram requisito antes de ligar, não aprendizado depois.
Perguntas frequentes
Preciso disso tudo para um piloto interno?
Para piloto interno, avaliação e teto de custo já bastam. Os outros três entram quando o agente fala com cliente.
Qual modelo usar?
A escolha do modelo é a decisão menos importante e a mais discutida. Troca-se de modelo em uma tarde quando existe conjunto de avaliação. Sem ele, a troca é fé.
Quanto custa colocar um agente em produção?
A faixa está em quanto custa software sob medida, e a maior parte do esforço está justamente nos cinco itens acima, não em conectar a API. Peça um diagnóstico se quiser avaliar o seu caso.