Neste artigo
- Quantos acessos de IA o site perde com o Disallow da CDN?
- Por que isso não aparece em nenhum relatório?
- Como verificar se o robots.txt do seu site bloqueia o GPTBot?
- Bloquear IA é sempre errado?
- Quem deve ser dono dessa decisão?
- O que colocar na sua rotina de verificação?
- O que mais perguntam sobre esse bloqueio?
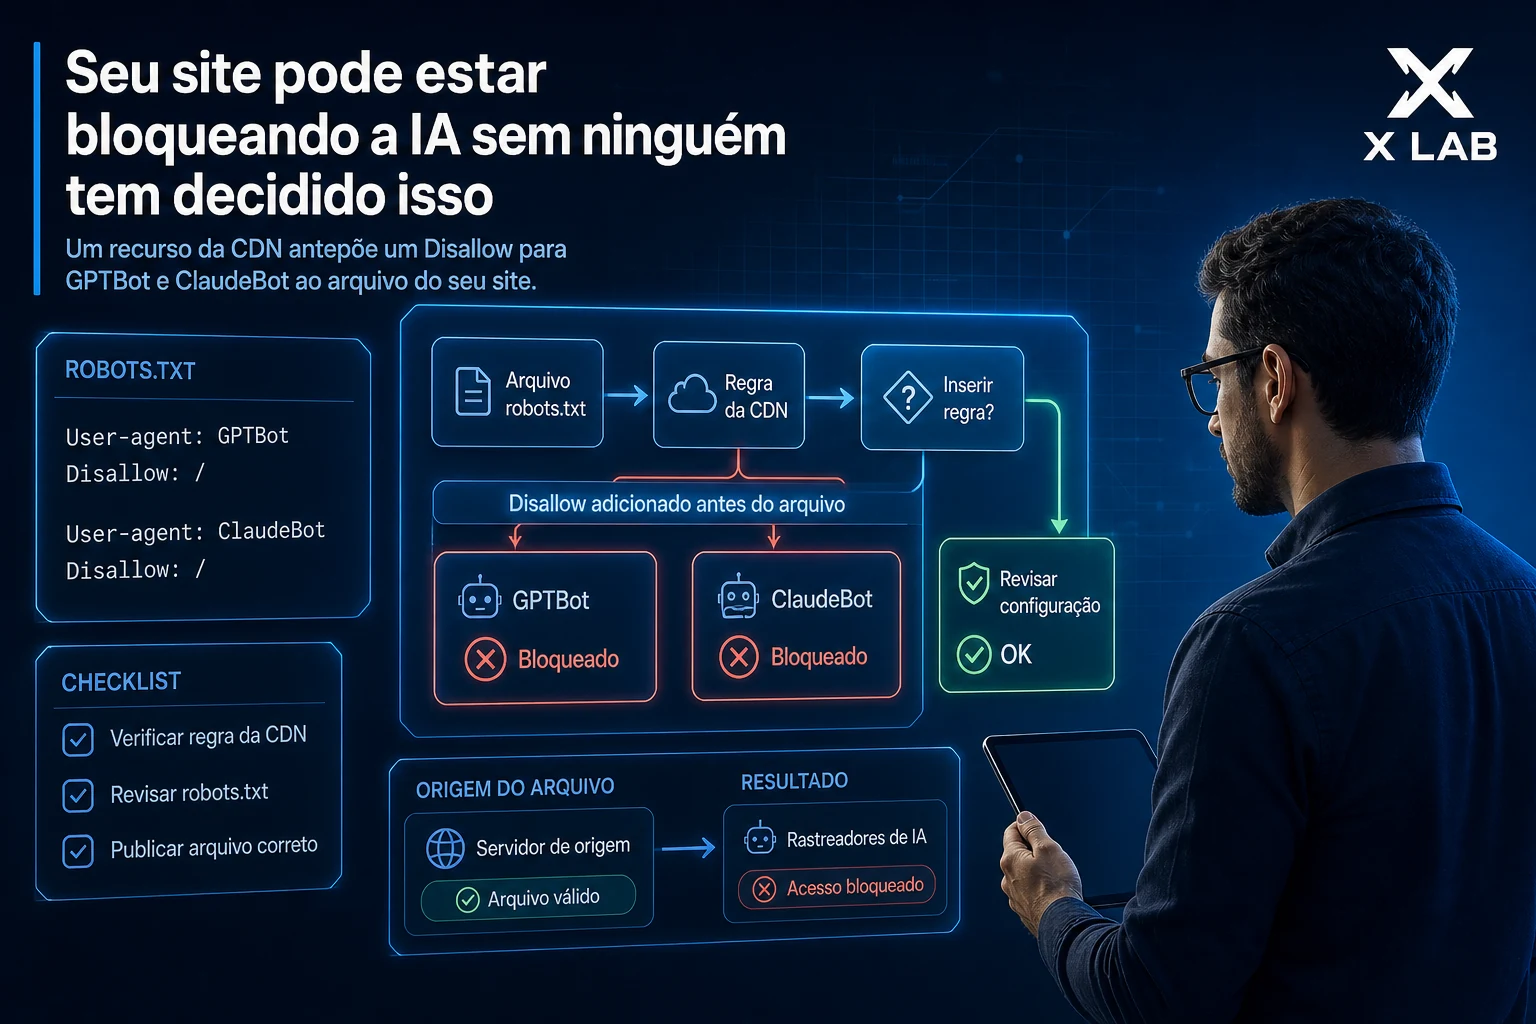
Muitas empresas estão invisíveis para ChatGPT e Perplexity por causa de uma caixinha marcada no painel da CDN, não por causa do conteúdo. O recurso se chama managed robots.txt, e quando ligado ele antepõe um bloco ao arquivo do seu site mandando GPTBot, ClaudeBot e Google-Extended embora. O arquivo do seu site pode dizer o contrário logo abaixo, mas o bloqueio vem primeiro.
Ninguém decidiu isso numa reunião. Ligou junto com outra configuração de segurança, e não deixa sintoma visível.
Quantos acessos de IA o site perde com o Disallow da CDN?
Medimos em dois domínios nossos, mesma stack e mesma janela de sete dias. A única diferença era esse flag:
| Domínio | Hits do GPTBot em 7 dias |
|---|---|
Com robots.txt limpo |
36 hits |
| Com o bloco da CDN | 1 hit |
| Fonte: medição própria da SyntaxLab em dois domínios, apurado em 29/08/2026 | |
Um site sendo lido e outro não, com o mesmo conteúdo e o mesmo esforço de produção.
Por que isso não aparece em nenhum relatório?
Porque o site não cai, não dá erro e não sai do Google. O Google Search Console continua mostrando impressão e clique normalmente, já que o Googlebot não é afetado.
O que muda é uma coisa que a maioria das empresas não mede: quantos robôs de IA leram o site. Sem esse número, o bloqueio pode durar meses.
E há um segundo efeito, mais silencioso. O bloco também publica uma declaração de política em nome do domínio, na forma Content-Signal: ai-train=no. Pode ser exatamente o que a empresa quer dizer. O problema é dizer isso sem saber.
Como verificar se o robots.txt do seu site bloqueia o GPTBot?
Não olhe o arquivo no repositório. Olhe o que o servidor entrega:
curl https://seudominio.com.br/robots.txtProcure por qualquer Disallow antes das suas próprias regras, e por qualquer bloco marcado como gerenciado por terceiro. Depois confirme o acesso na prática:
curl -A "OAI-SearchBot/1.0" -o /dev/null -w "%{http_code}\n" https://seudominio.com.br/blog/
curl -A "GPTBot/1.2"        -o /dev/null -w "%{http_code}\n" https://seudominio.com.br/blog/
Precisa dar 200 nos dois. Se der 403, alguma regra de borda está barrando. Se der 429, existe limite de taxa pegando o robô.
Bloquear IA é sempre errado?
Não, é decisão de negócio legítima, e o recurso existe porque muita empresa quer exatamente isso. Editora que vive de assinatura tem motivo real para não alimentar modelo de graça.
O que não faz sentido é ter as duas políticas ao mesmo tempo. Se o marketing produz conteúdo para ser encontrado e a infraestrutura bloqueia quem encontraria, alguém está pagando por trabalho que não pode dar resultado.
E vale conhecer a distinção que a maioria das listas de bloqueio apaga:
| Tipo | Robôs | Bloquear significa |
|---|---|---|
| Treino | GPTBot, ClaudeBot, CCBot, Google-Extended | Seu conteúdo não entra no treinamento do modelo |
| Busca | OAI-SearchBot, PerplexityBot, Claude-SearchBot | Você some das respostas |
Bloquear o segundo grupo é sair do ChatGPT Search e do Perplexity de vez. E como a OpenAI documenta que reaproveita um único rastreio para os dois usos quando ambos estão liberados, bloquear o de treino também reduz a leitura na prática.
Quem deve ser dono dessa decisão?
Ela cai entre cadeiras, e é por isso que ela erra. Marketing não abre painel de CDN, e infraestrutura não é cobrada por visibilidade. O resultado é uma política de conteúdo definida por quem não tem contexto de conteúdo.
Na prática, o arranjo que funciona é simples: a decisão é do negócio, a execução é da infraestrutura, e a verificação entra na rotina de checagem do site, junto com certificado e backup.
O que colocar na sua rotina de verificação?
robots.txtconferido no ar, não no repositório, depois de qualquer mudança de CDN, plano ou plugin- Status 200 para os user-agents de busca por IA
- Contagem de robô de IA verificado por IP, não por user-agent, porque user-agent é texto livre
Se quiser saber se as suas páginas realmente entraram no índice do ChatGPT, existe teste direto para isso, e ele é diferente de olhar log.
O que mais perguntam sobre esse bloqueio?
Isso afeta o ranqueamento no Google?
Não, o bloco atinge o Google-Extended, que controla treino de IA, e não o Googlebot. O que muda é a elegibilidade para AI Overviews e Gemini.
Quanto tempo depois de desbloquear volta ao normal?
A OpenAI documenta cerca de 24 horas para os sistemas dela ajustarem depois de mudança no robots.txt. O rastreio em si depende de demanda, então pode levar bem mais.
Vocês verificam isso em auditoria?
Verificamos, junto com o resto da checagem de infraestrutura e segurança. Está no mesmo espírito do checklist de aceite de sistema. Peça um diagnóstico se quiser saber em que estado está o seu.