Neste artigo
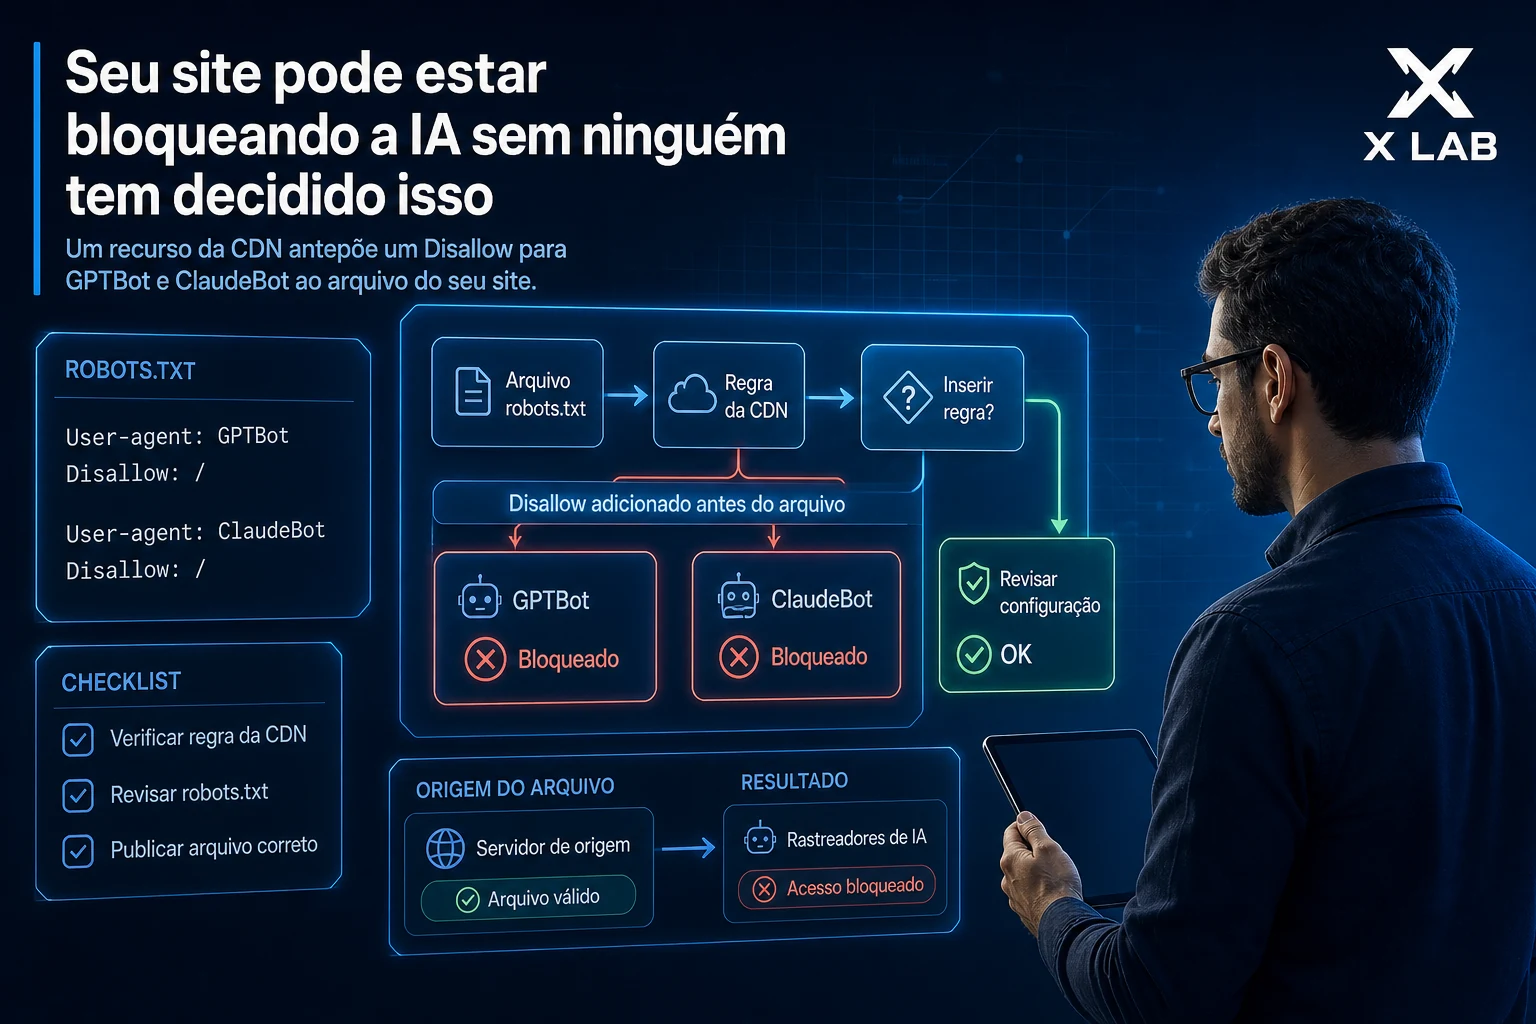
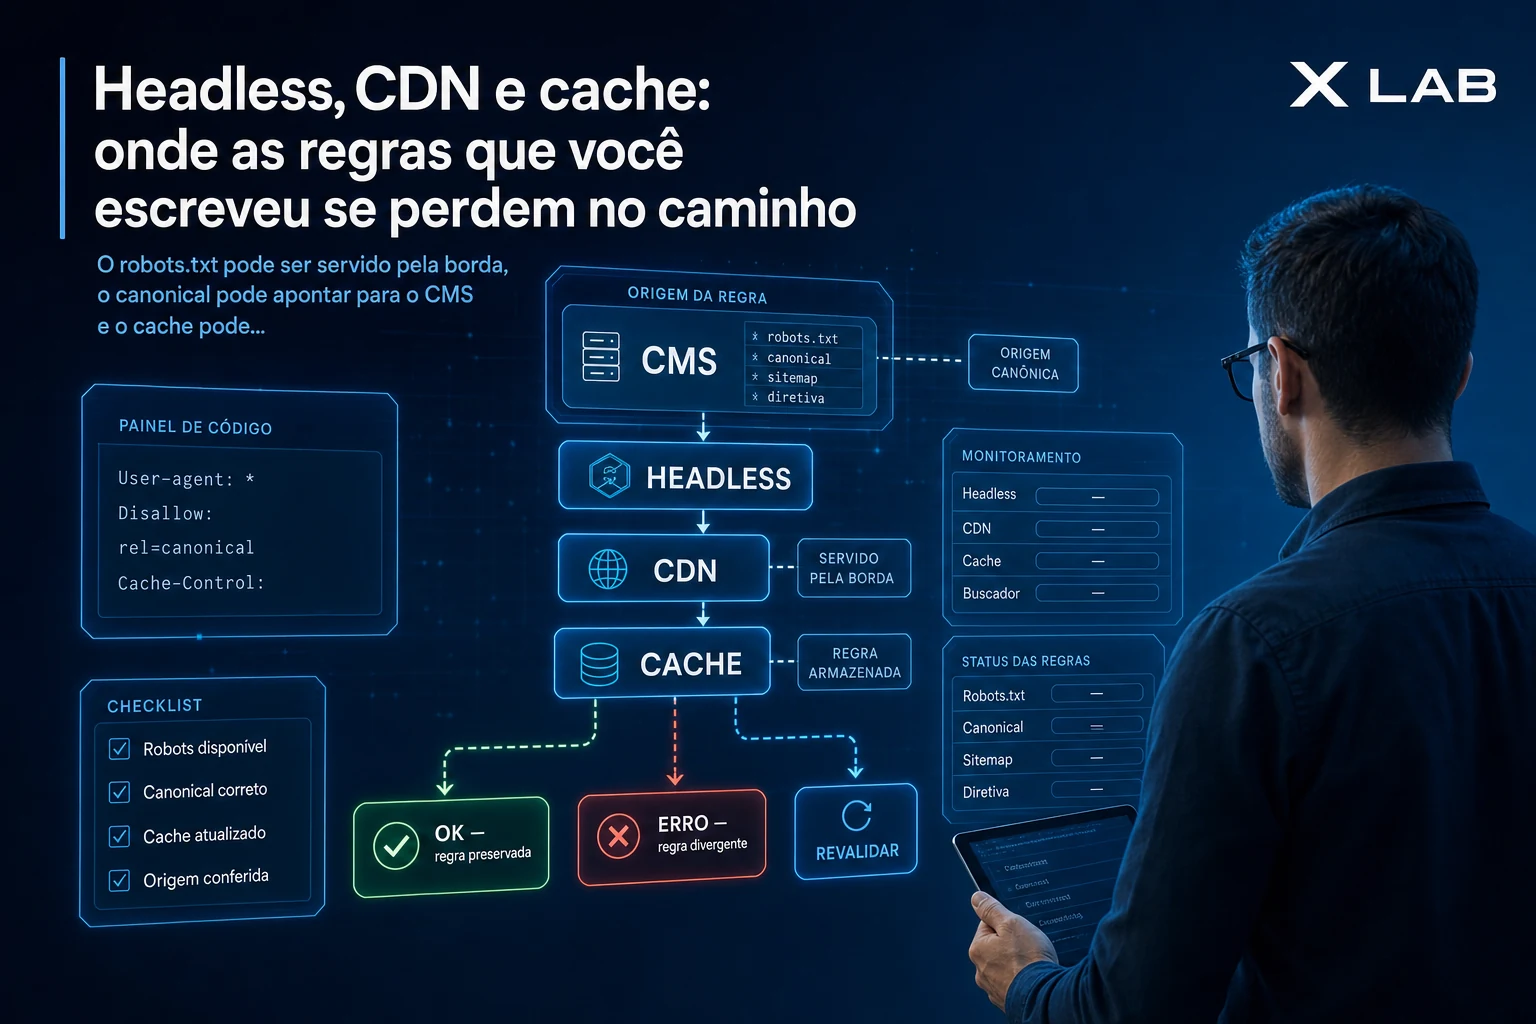
Em arquitetura headless, com CDN na frente e cache em duas camadas, a regra que você escreveu quase nunca é a regra que o robô recebe. O robots.txt pode ser servido pela borda e não pelo seu servidor. O canonical pode apontar para o CMS em vez do site. E o cache pode entregar uma versão de horas atrás para o único visitante que importava.
Nenhum desses três aparece como erro. Todos aparecem como ausência de resultado.
Por onde a regra se perde?
Uma requisição em stack moderna passa por camadas que podem reescrever a resposta:
| Camada | O que ela pode alterar sem avisar |
|---|---|
| CDN | robots.txt, cabeçalhos, status para certos user-agents |
| WAF e regra de bot | 403 ou 429 para robô legítimo |
| Cache de borda | Idade do HTML entregue |
| Build ou sync do CMS | canonical, sitemap, URL das imagens |
| Servidor de origem | Aí sim, o seu arquivo |
A auditoria que só lê o repositório vê a última linha dessa tabela e ignora as quatro de cima.
O erro mais caro do headless
Vazamento do domínio do CMS para o HTML público. Acontece quando o conteúdo vem por API e alguém esquece de reescrever URL de imagem, de link interno ou do canonical.
O efeito é pior do que parece: você acaba pedindo aos buscadores e aos modelos que atribuam a autoria a cms.seudominio.com.br, um host que normalmente nem deveria estar público. O sinal de entidade se divide entre dois endereços e nenhum dos dois fica forte.
A verificação é uma linha:
curl -s https://seudominio.com.br/blog/ | grep -c "cms\."Tem que dar zero. Rode em algumas páginas, não só na home, porque o vazamento costuma estar no template de artigo.
Como o cache de borda atrapalha?
Cache de página inteira na CDN é ótimo para velocidade e péssimo para conteúdo recém-publicado, se ninguém limpar.
Num site nosso, uma regra cacheava HTML por duas horas com override_origin, ou seja, ignorando o cabeçalho da origem. Um artigo publicado aparecia para o mundo com atraso, e pior: durante a validação de um deploy, nós mesmos vimos a versão antiga e quase diagnosticamos um problema que não existia.
Duas saídas, e a escolha é de risco, não de gosto:
Limpar o cache no fim da publicação. Exige que o processo de publicação tenha credencial da CDN, ou seja, um token guardado no servidor. Mais rápido, e mais superfície exposta.
Baixar o tempo de cache do HTML. Não exige credencial nenhuma e é praticamente sem risco. Um pouco menos eficiente.
Para site que publica algumas vezes por semana, a segunda opção costuma ser a resposta certa. Guardar token de CDN em hospedagem compartilhada para economizar duas horas de atraso é uma troca ruim.
E o cache que você não controla?
Tem um terceiro, e ele é do lado do modelo. O ChatGPT mantém uma cópia integral de cada página que já buscou, chaveada por URL e compartilhada entre todos os usuários. A cópia é considerada fresca por cerca de 30 minutos; passado isso, o usuário ainda recebe a versão velha na hora enquanto uma atualização roda em segundo plano.
Foram documentadas cópias servidas mais de 90 dias depois da coleta. E o detalhe que fecha a questão: Cache-Control: no-store é ignorado, e noindex também.
Isso significa que a frequência com que suas páginas são relidas não é decidida por você. É decidida por quantas pessoas perguntam sobre elas ao ChatGPT. Página popular fica fresca. Página impopular envelhece indefinidamente.
Consequência prática: corrigir um erro no site não corrige a cópia que o modelo tem. Republicar não força releitura.
O que colocar no processo de deploy
Seis verificações automatizáveis, todas por linha de comando, rodando depois de todo deploy:
robots.txtdo domínio, conferindo que nenhuma camada anteriormente inseriuDisallow- Status 200 para os user-agents de busca por IA
- Zero ocorrência do host do CMS no HTML público
canonicalapontando para o domínio público, em uma página de cada tipositemap.xmlcom contagem de URLs dentro do esperado- Peso do HTML abaixo de 4 MB e conteúdo principal visível sem JavaScript
São seis linhas de shell. O valor não está na sofisticação, está em rodar sempre, porque esse tipo de regressão entra em silêncio e sai cara.
Perguntas frequentes
Headless vale a pena mesmo assim?
Vale, pelos motivos de sempre: separação entre edição e entrega, site estático rápido e barato, e CMS que pode cair sem derrubar o site. O que muda é que a lista de verificações cresce, e ela precisa ser automática.
Como sei se meu cache está atrapalhando?
Compare a resposta normal com uma com parâmetro aleatório na URL. Se o conteúdo for diferente, você está vendo cache. É o teste mais rápido que existe e resolve metade dos falsos diagnósticos.
Vocês revisam isso em site que já existe?
Revisamos, e é uma das coisas mais rápidas de checar em uma auditoria. Está na mesma linha do checklist antes de dar aceite em um sistema. Peça um diagnóstico.