Neste artigo
Dá para saber quantos robôs de IA leram o seu site, quais páginas eles leram e se o ChatGPT tem as suas URLs no índice. Nenhuma dessas três coisas aparece no Google Analytics ou no Search Console, e as três são mensuráveis com o que você já paga.
O que não funciona é contar por user-agent. User-agent é texto livre: qualquer pessoa consegue bater no seu site dizendo que é o GPTBot, e o seu log vai registrar como se fosse.
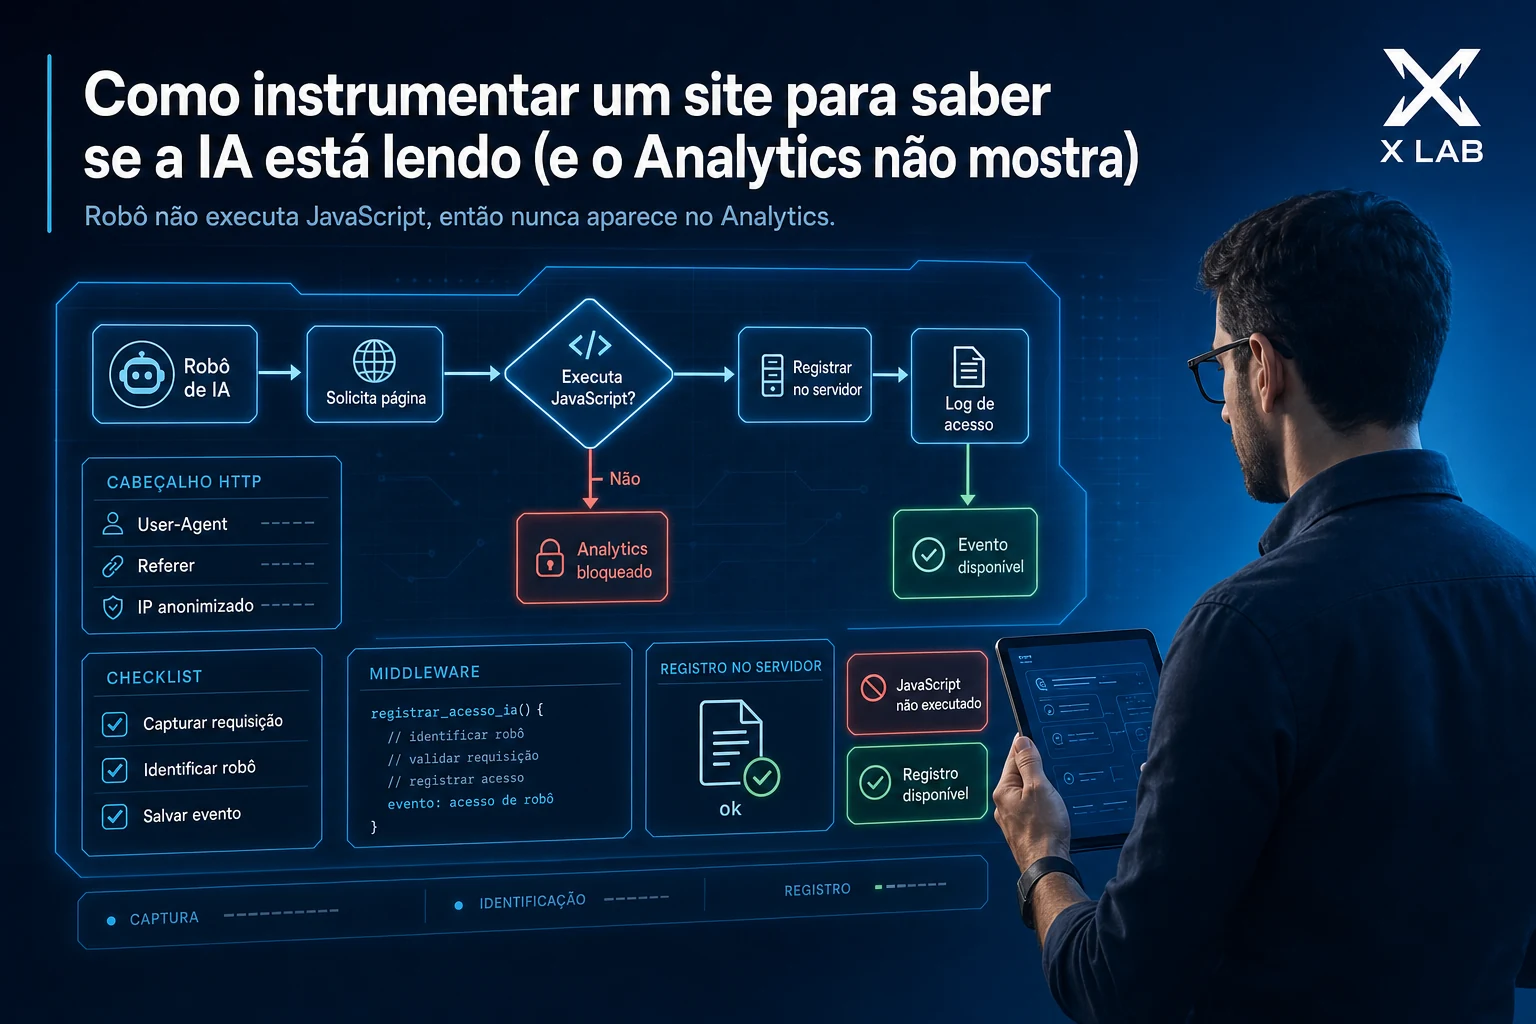
Por que o Analytics não mostra robô?
Por desenho. O Google Analytics roda JavaScript no navegador do visitante, e robô não executa JavaScript. Ele nunca vai aparecer ali.
O GA4 tem desde maio de 2026 um canal padrão chamado “AI Assistant”, mas ele mede outra coisa: a sessão de quem clicou na resposta e veio parar no seu site. E mede por baixo, porque clique vindo de IA sem referrer cai em Direct. Trate como piso, nunca como total.
Leitura e clique são métricas diferentes, e a leitura vem antes.
Como medir a leitura de forma confiável?
Classificando por IP, não por texto. A Cloudflare mantém uma lista de bots verificados e confere a origem da requisição contra os blocos declarados por cada empresa. O campo é verifiedBotCategory, e a categoria é "AI Crawler".
Requisição que se diz GPTBot mas vem de IP residencial não recebe a categoria. Testamos exatamente isso: uma requisição forjada apareceu no log bruto e não apareceu na consulta filtrada.
A consulta sai pela Analytics GraphQL, com token de permissão de leitura de analytics da zona. Duas limitações que mudam o desenho do painel:
A retenção é curta, pouco mais de sete dias no plano gratuito. Pedir trinta dias devolve erro de quota. Se você quer série histórica, precisa guardar por conta própria.
O user-agent vem inteiro, então precisa normalizar para o nome do robô antes de agregar, senão o mesmo bot aparece em várias linhas por causa de versão.
Qual robô olhar primeiro?
Não é o mais óbvio. A ordem por utilidade real:
| Robô | O que significa |
|---|---|
| ChatGPT-User | Alguém perguntou e o modelo abriu a sua página. Página aberta vira citação em 74% das vezes, contra 7% da apenas recuperada. |
| PerplexityBot | Rastreio do Perplexity, historicamente o primeiro a achar site novo. |
| OAI-SearchBot | Pode passar meses sem aparecer sem que isso signifique problema. |
| ClaudeBot, GPTBot | Rastreio de treino, que na prática também alimenta busca. |
Aquele terceiro item merece destaque porque engana muita gente. A OpenAI documenta que pode usar o resultado de um único rastreio para os dois bots quando ambos estão liberados. Ausência do OAI-SearchBot no log não é evidência de estar fora do índice.
Como saber se estou no índice, então?
Perguntando ao próprio modelo, com o acesso externo desligado. O parâmetro external_web_access: false proíbe o ChatGPT de abrir a URL na hora: se ainda assim ele resume a página, o conteúdo veio do índice interno.
É a única medição direta que existe hoje, e ela é binária. Rode contra um punhado de URLs representativas uma vez por mês, sempre incluindo uma página publicada ontem como controle negativo. Se a página nova responder que está indexada, o teste não está discriminando e o resultado não vale.
Que números colocar no painel?
Quatro, e nessa ordem de importância:
- URLs distintas lidas por IA. Cobertura vale mais que volume: 200 acessos numa página só é pior que 40 acessos em 40 páginas.
- Hits do ChatGPT-User, que é o sinal de leitura de verdade.
- Quantas URLs estão no índice, pelo teste direto, medido mensalmente.
- Sessões do canal AI Assistant no GA4, com a ressalva de que subconta.
O que não serve como métrica de exposição é filtrar por utm_source=chatgpt.com. Esse parâmetro marca clique de saída, e as páginas que o modelo abre sozinho no modo thinking, justamente as de 74% de citação, não carregam UTM nenhum. Filtrar por ele conta os cliques e perde as leituras.
Quanto isso custa para montar?
A leitura de crawler sai de graça se você já usa Cloudflare, porque a Analytics GraphQL está no plano gratuito. O teste de índice custa centavos por URL, porque é chamada de API.
O custo real é de engenharia, e é pequeno: uma consulta GraphQL, uma normalização de user-agent e um lugar para guardar o resultado antes da retenção expirar. Cabe em um bloco novo de um painel que já exista, do jeito que a gente trata monitoramento em geral: instrumentar primeiro, decidir depois.
Perguntas frequentes
Dá para fazer sem Cloudflare?
Dá, com log bruto do servidor e conferência reversa de IP contra as faixas publicadas pela OpenAI em openai.com/searchbot.json e nos arquivos equivalentes. Dá mais trabalho e chega no mesmo lugar.
Com que frequência devo olhar?
Semanal para leitura de crawler, mensal para índice. Movimento diário é ruído: o rastreio é irregular por natureza e responde a demanda de usuário, não a calendário.
Vocês montam esse painel?
Montamos, normalmente como bloco dentro do painel que o cliente já tem, não como ferramenta separada. Peça um diagnóstico e a gente diz o que já dá para medir com o que você tem hoje.