Neste artigo
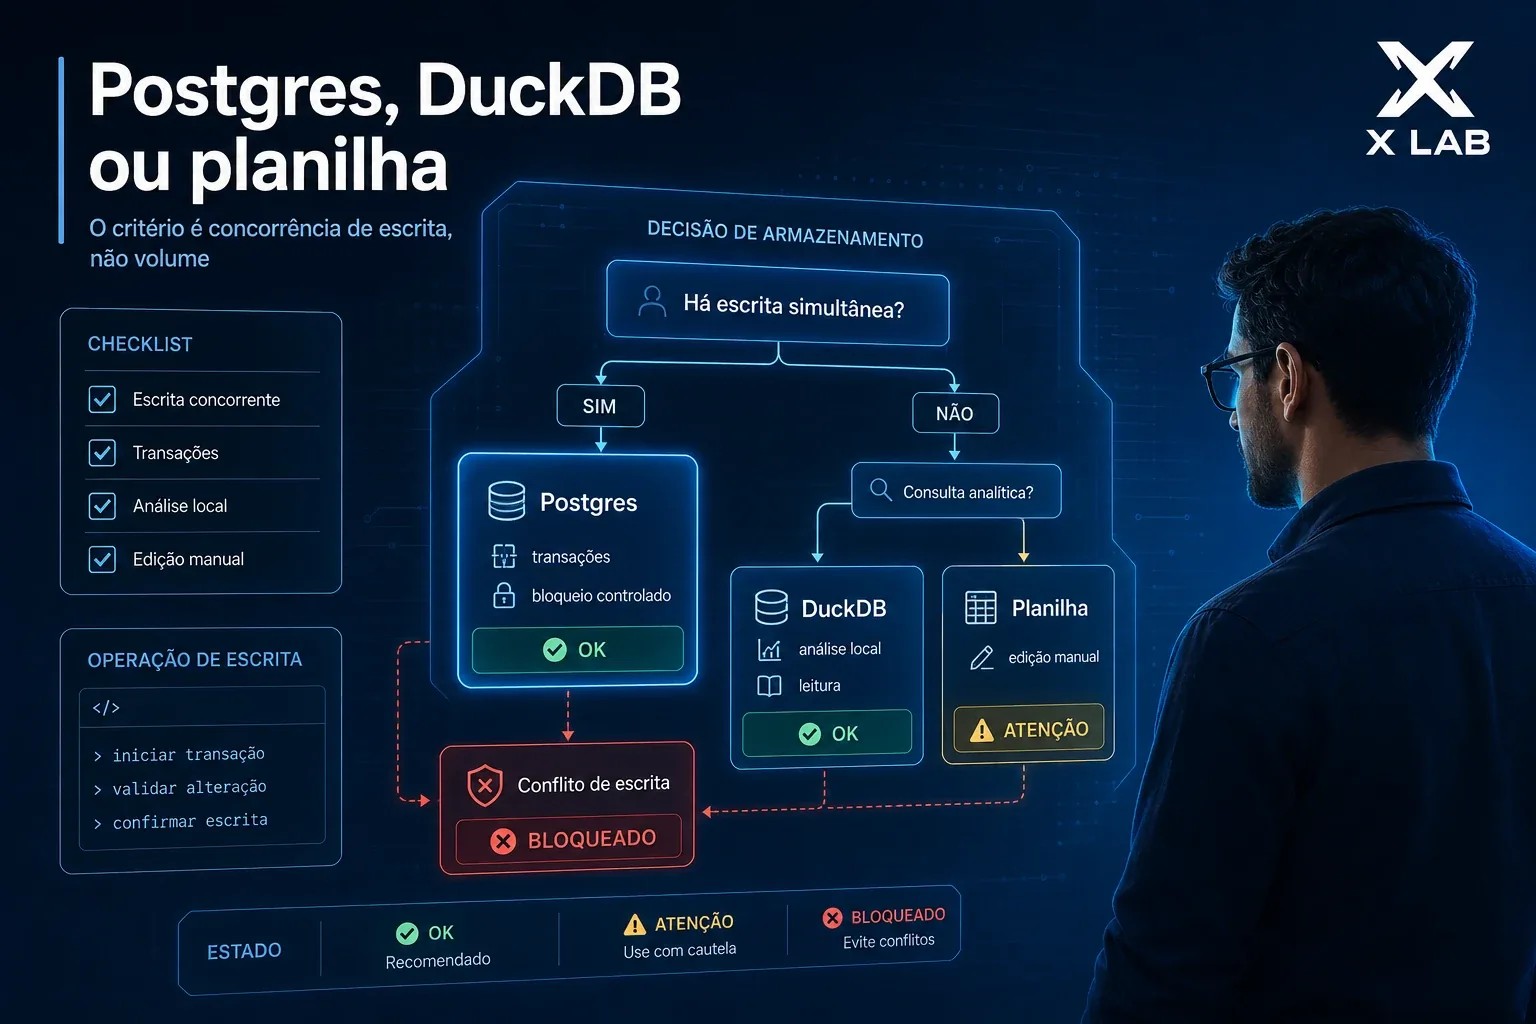
Se a sua análise cabe em menos de alguns milhões de linhas e roda na máquina de uma pessoa, DuckDB resolve sem servidor e sem custo de infraestrutura. Se várias pessoas precisam gravar ao mesmo tempo e o dado é operacional, o lugar dele é o PostgreSQL. Planilha continua sendo a resposta certa em mais casos do que a área técnica costuma admitir.
Este texto separa os três cenários pelo que realmente muda a decisão, que é concorrência de escrita e não volume de dado. Volume assusta e quase nunca decide, porque as três opções aguentam mais do que a intuição sugere. Quem escolhe por volume costuma migrar cedo demais e herdar manutenção que não precisava existir.
Onde cada opção ganha de verdade?
A pergunta útil não é qual ferramenta é melhor, é quem escreve no dado e quantos escrevem ao mesmo tempo. Uma pessoa mantendo um arquivo tem necessidade completamente diferente de dez pessoas gravando simultaneamente. Essa distinção sozinha resolve a maioria das decisões antes de qualquer discussão sobre desempenho. Volume entra depois, como critério de desempate e não como critério principal.
| Cenário | Onde o dado deve morar | Por quê |
|---|---|---|
| Relatório mensal de uma pessoa | Planilha | Custo zero de aprendizado e revisão fácil |
| Análise pesada sobre arquivo grande | DuckDB | Roda no processo, sem servidor para manter |
| Sistema com muitos usuários gravando | PostgreSQL | Transação, concorrência e integridade |
| Painel que lê de um sistema em uso | PostgreSQL com réplica de leitura | Não competir com a escrita da aplicação |
| Fonte: critérios aplicados em projetos de cliente que entreguei, apurado em setembro de 2026. | ||
Volume aparece pouco na tabela acima e concorrência aparece em quase toda linha, o que não é coincidência. Um banco analítico moderno processa dezenas de milhões de linhas num notebook comum sem reclamar. O que nenhum deles faz bem é receber escrita simultânea de muita gente mantendo consistência. Essa capacidade é justamente o que define um banco transacional como o PostgreSQL.
Quando a planilha ainda é a escolha certa?
A planilha continua certa quando uma pessoa mantém o arquivo, o resultado é revisado a olho e o erro custa pouco. Ela tem vantagens reais que a área técnica costuma desprezar, como revisão visual imediata e custo zero de aprendizado. Trocar isso por sistema antes da hora cria manutenção nova sem resolver problema existente. Muito projeto de software começa resolvendo um problema que a planilha não tinha.
A planilha quebra em três situações, e todas envolvem gente e não tamanho de arquivo. Várias pessoas editando a mesma aba geram sobrescrita silenciosa e perda de trabalho. Regra de negócio escondida em fórmula que ninguém mais entende vira risco quando a pessoa sai. Histórico que precisa ser auditável não existe de forma confiável em arquivo compartilhado. Escrevi o critério completo em planilha, Notion ou sistema próprio.
O que o DuckDB resolve que o PostgreSQL não resolve?
Ele elimina o servidor da equação por completo, e essa é a diferença que muda o custo operacional. Você aponta para arquivos que já existem, escreve SQL e recebe resposta, sem subir serviço nenhum. Não há processo rodando, então não há o que monitorar, atualizar ou pagar quando ninguém está usando. Para análise que roda uma vez por dia ou por semana, essa economia é o argumento inteiro.
Análise sobre arquivo bruto: consultar CSV e Parquet direto do disco elimina a etapa de carga que costuma ser metade do trabalho de um pipeline pequeno. O arquivo continua sendo a fonte de verdade e nada precisa ser duplicado. Isso reduz a chance de o dado analisado divergir do dado original. Pipeline com menos etapas tem menos lugares onde a informação pode ser transformada por engano.
Custo operacional próximo de zero: sem servidor não existe fatura mensal, atualização de segurança nem janela de manutenção. A biblioteca vive dentro do processo que faz a análise e morre junto com ele. Para equipe pequena, isso remove uma responsabilidade inteira de operação. Menos serviço rodando significa menos alerta de madrugada e menos superfície exposta a ataque.
Velocidade em agregação: o dado é guardado por coluna, que é o formato certo para somar, agrupar e filtrar volume grande. Consulta que varre poucas colunas de muitas linhas fica muito mais rápida que num banco orientado a linha. É exatamente o padrão de acesso de relatório e painel, que lê muito e escreve pouco. Consulta que precisa do registro inteiro continua sendo melhor atendida por banco orientado a linha.
A escolha entre os dois formatos depende do padrão de leitura e não do tamanho do arquivo. O detalhamento de quando ele substitui o banco tradicional está em DuckDB, o que é e quando ele substitui o banco de dados.
Onde o DuckDB não serve?
Ele não serve como banco de aplicação com vários usuários gravando ao mesmo tempo, porque não foi projetado para isso. Também não serve quando o dado precisa estar disponível para vários serviços simultaneamente pela rede. Escrita concorrente é justamente o ponto em que um banco embutido perde para um banco servidor. Usar a ferramenta fora do propósito dela produz corrupção de dado ou trava de arquivo.
Outro limite prático aparece quando o volume passa da memória disponível com folga na máquina. Ele lida bem com dado maior que a memória, e ainda assim existe um ponto em que infraestrutura distribuída passa a compensar. Esse ponto é bem mais alto do que a maioria imagina e raramente é atingido por empresa média. Antes de assumir que chegou lá, vale medir em vez de estimar.
Dá para usar os dois no mesmo projeto?
Dá, e esse é o arranjo mais comum em empresa que já tem sistema rodando em produção. O PostgreSQL guarda o dado operacional com transação e integridade, e o DuckDB faz a análise pesada sobre uma cópia. Assim o relatório não disputa recurso com a aplicação que atende usuário. A cópia pode ser atualizada uma vez por dia na maioria dos casos, porque análise raramente precisa do dado do último segundo.
Esse desenho evita o erro clássico de rodar consulta analítica pesada direto no banco de produção. Relatório de fechamento de mês derrubando o sistema no dia mais movimentado é situação comum e completamente evitável. Separar leitura analítica de escrita operacional custa pouco e remove uma classe inteira de incidente. Quando a atualização diária não basta, uma réplica de leitura resolve sem misturar as cargas.
Como decidir sem travar a escolha para sempre?
Escreva a consulta em SQL padrão e mantenha a lógica de negócio fora da ferramenta de armazenamento. Assim a migração entre as três opções vira trabalho de transporte de dado e não reescrita de regra. Lógica presa em fórmula de planilha ou em recurso exclusivo de um banco é o que torna migração cara. Essa disciplina custa pouco durante a construção e preserva a liberdade de mudar depois.
Se a dúvida for entre bancos relacionais e não relacionais, o critério está em PostgreSQL ou MongoDB, como escolher. Para testar antes de decidir, a documentação oficial do DuckDB tem exemplos que rodam em segundos sem instalar servidor. Medir com o seu dado real vale mais que qualquer comparativo genérico de desempenho.